Codexで複数の画像を扱っていると、想定以上にトークンを消費することがあります。私もKindle本の漫画画像をまとめて生成した際、この問題にぶつかりました。
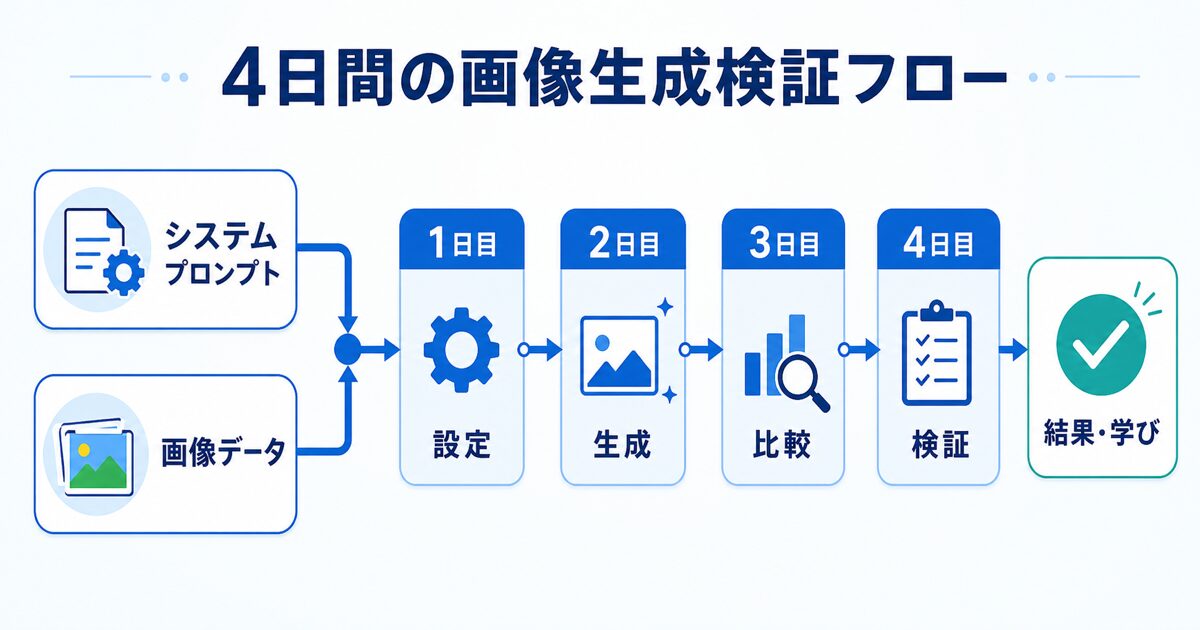
そこで4日間、指示文の長さ、Vault(第二の脳)の読み込み、システム側の固定的な消費、画像データの入出力を順番に比較しました。本記事では、その検証結果と、少量の修正はCLI、大量生成はアプリから手動で行うという現在の使い分けを紹介します。
4日間、何を検証してきたか
最初に試したのは、指示文を5行以内に短縮する応急処置でしたが、効果は限定的でした。次に「本当の原因はVaultの読み込み量ではないか」という仮説を立て、隔離環境あり/なし・Vault既読/未読の組み合わせで実測しましたが、これも主因とは言えませんでした。
最後に残った候補は、システムプロンプト自体の固定費と、画像生成のやり取りで発生するbase64データ(画像をテキストとして送受信するための形式)の2つです。ここを切り分けて実測したところ、画像を生成する回数が増えるほどトークン消費がほぼ比例して増えていくことが確認でき、少なくとも私が試した条件では「画像データそのものの重さ」の影響が大きいとわかりました。
たどり着いた結論:CLIとアプリの使い分け
検証を踏まえて決めた運用は、次の通りです。
1ページ単発の差し替え
CLIを隔離環境で使います。1コマだけなら画像データの負荷も小さく、CLIの手軽さを活かせます。
全ページ一括生成
Codexアプリを手動で直接叩きます。数十コマ分の画像データが一気に発生する場面では、自動化でまとめて回すよりも、手動で状況を見ながら進めた方がコストも精度も安定します。
判断基準の目安
数コマ程度ならCLI隔離環境、それ以上まとまった枚数ならアプリ手動、という枚数ベースの目安で判断しています。急いでいない場合は、1ページの差し替えでもアプリを使うことがあります。
実際の結果・体験談
「全部自動で流せた方がラク」というのが最初の理想でしたが、今回の検証を経て、私の作業では量が多いときに手動へ切り替えた方が、消費量を管理しやすく、生成結果も確認しやすいとわかりました。厳密な数値比較まではできていないため、あくまで自分の環境・使い方の範囲での結論として書いています。
指示文の短縮、Vaultの読み込み量という最初の2つの仮説は外れましたが、外れたこと自体に意味がありました。候補を1つずつ削っていったからこそ、最後に影響の大きい要因まで絞り込めたからです。
よくある質問(FAQ)
Q. なぜ最初からシステムプロンプトやbase64入出力を疑わなかったのですか?
A. 体感として一番わかりやすかったのが指示文の長さとVaultの読み込み量だったため、まずそちらから検証しました。結果的に遠回りにはなりましたが、候補を1つずつ削っていったことで、最後に影響の大きい要因まで絞り込めました。
Q. この使い分けは他のAIツールでも応用できますか?
A. 画像などのバイナリデータをやり取りするAIツール全般で、同じような「データ量に比例したコスト」が発生している可能性はあります。気になる場合は、同じように条件を分けて実測してみることをおすすめします。
Q. 「全部自動化」を諦めたということですか?
A. いいえ、自動化自体は今も基本方針です。ただ、量が多い場面まで無理に自動化にこだわるより、そこだけあえて手動に振り切った方が結果的に安定する、という判断基準を1つ増やした形です。
まとめ
指示文の短縮、Vaultの読み込み量、そしてシステムプロンプト+base64入出力と、4日間かけて候補を1つずつ検証してきました。今回の環境で実測した範囲では、画像1枚あたりのbase64データのコストの影響が大きいという結論になりました。1ページ単発の差し替えはCLIを隔離環境で、全ページ一括生成はCodexアプリを手動で、という使い分けに落ち着いています。「全部自動」ではなく「量が多い場面ではあえて手動を組み合わせる」というのが、今回たどり着いた運用方針です。