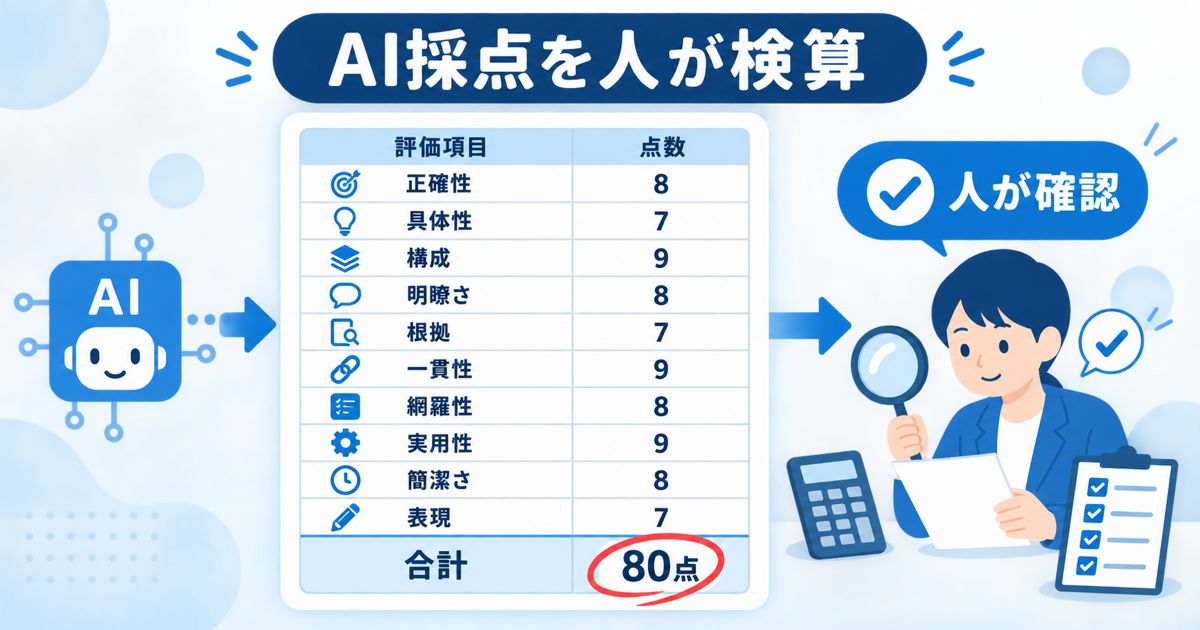
Kindleで本を作るとき、原稿・マンガ・図解・電子書籍ファイルが一通りそろった段階で、ぼくは最終評価をAI(Codex)に採点させています。10項目の採点基準と章ごとの評価表をプロンプトに書いておき、点数とコメントをレポートに書き出させる仕組みです。ある本でこの採点を回したところ、「84.4点」という数字の裏に、必須2節の抜け、電子書籍を組み立てるスクリプトのバグ、そして総合点の計算ミスという3つの問題が隠れていました。この記事では、AIに完成度の判定を任せるときに何を確認したほうがいいかを、実際に起きたことをもとにまとめます。
AIに「本の採点」を任せている理由
ぼくが人手だけで最終チェックをすると、細かい表記ゆれや章の抜けを見落とすことがあります。10項目の基準(構成・文章・図版・法令チェック・ファイルの完成度など)をAIに渡して、原稿や画像を実際に開いて検査させると、この手の抜けを機械的に拾ってくれます。
あくまで下チェックの位置づけで、最終的には自分で通し読みします。ただ、下チェックとしては手が回らない部分を補ってくれるので、工程に組み込んでいます。今回の件も、この採点を入れたおかげで気づけた抜けが含まれていました。
見つかった3つの問題
問題1:必須にしていた2節が、そもそも書かれていなかった
最初の採点で返ってきたのが「総合84.4点、10項目のうち不合格1件」でした。不合格は「ファイルの完成度」の項目で、理由は「参考資料」と「奥付」が原稿にもDOCXにもEPUBにも見当たらない、というものでした。
構成表では「おわりに → 読者プレゼント → 参考資料 → 奥付」という並びを最初から指定していました。それなのに、参考資料と奥付の2節は書く工程が抜け落ちていて、ファイルを統合するときも気づいていませんでした。今回の採点を入れなければ、奥付も参考資料もない本をそのまま出しかけていたことになります。
問題2:ビルドスクリプトが、原稿の並び順を無視していた
抜けていた2節を書き足したあと、電子書籍を組み立てるビルドスクリプト(Claude Codeで一緒に組んだものです)を見直したら、別の問題が出てきました。
このスクリプトは、巻末(読者プレゼント・参考資料・奥付)を出力する順番が、コードの中に固定の並びで直接書き込まれていました。原稿の実際の並び順を読まずに、決め打ちの順番で出力する作りだったのです。そのため、原稿では「読者プレゼント → 参考資料 → 奥付」なのに、EPUBでは順番が入れ替わっていました。
同じ本のWord版を作るスクリプトのほうは、原稿を頭から順に読んで見出しを処理する作りだったので、正しい順番で出ていました。EPUB側だけ、コードに書いた固定の順番が残っていたわけです。これまで出した本ではたまたま固定の順番と原稿の順番が一致していて、表に出ていなかった潜在的なバグでした。スクリプトを原稿に合わせて直し、ファイルを作り直して、チェックツール(epubcheck)でエラーがゼロになることを確認しました。
問題3:総合点の足し算そのものが間違っていた
修正したうえで再採点させたら、「総合85.2点・全10項目合格」になりました。ここまでなら「AIの採点は役に立つ」で終わる話です。
ですが、再採点のレポートと1回目を見比べていて、もう一つ気づきました。1回目の「総合84.4点」という数字そのものが、各項目の点数を足し合わせる計算を間違えていました。正しく足すと83.4点でした。1点ぶん、AIが自分で出した点数の合計を打ち間違えていたわけです。
合否の結論が変わる差ではありませんでした。それでも、「AIが出してきた総合点は、そもそも足し算からして合っていないことがある」と実際に見てしまうと、点数の受け取り方が変わります。
AIによる採点を使うときに確認していること
この件のあと、AIに完成度の判定をさせるときは、次のことを意識しています。
- 総合点だけを見ない。各項目の点数と、減点の理由まで読む
- 「合格」でも、指摘コメントは全部つぶす。点数が良くても抜けは抜け
- 数字を検算する。項目の点数を自分で足し直して、総合点と合っているか見る
- ファイル構成(章の並び・巻末の順番)は、点数と別に実物を開いて目で確認する
- 最後は自分で通し読みする。AIの点数は下チェックであって、合格判定ではない
AIに採点させること自体はやめていません。人間だけだと見落とす箇所を拾ってくれるのは事実です。ただ、返ってきた点数を「結論」として扱うのはやめて、どこを見直すべきかの手がかりとして使うようにしました。
よくある質問(FAQ)
Q. AIの採点をやめたほうがいいということですか?
A. いいえ。今回も必須2節の抜けはAIが拾ってくれました。やめるべきなのは「点数が出たら合格」という受け取り方で、採点を下チェックに使うこと自体は続けています。
Q. どうやって点数を検算するのですか?
A. レポートに各項目の素点が並んでいるので、それを電卓で足し直して総合点と突き合わせるだけです。特別なことはしていません。数字が合わなければ、他の記述も疑って読みます。
Q. AIが出した「合格」を最終判断にしていないなら、何を最終ゲートにしていますか?
A. 自分で全編を通し読みして、気になった箇所を直す工程です。過去には、AIの採点が高得点でも、通し読みで20項目ほど直した本があります。出版物である以上、そこは人間が責任を持つ部分だと考えています。
まとめ
本の最終評価をAIに採点させたら、必須2節の抜けを拾ってくれた一方で、電子書籍ファイルの並び順を決めるスクリプトのバグと、総合点の足し算ミスが見つかりました。AIによる採点は、点数そのものが間違っていることがあります。総合点で判断を止めず、減点理由・検算・実物確認・通し読みまでやることで、防げる事故があるという話でした。
おまけ:無料キャンペーンのお知らせ
本文の内容とは別件ですが、マンガ「マンガでわかる AIエージェントに介護をまかせる」を期間限定で無料公開しています。介護に関わる場面で、AIをどう使えるかをマンガでまとめた一冊です。「AIエージェントにまかせる」シリーズの1冊で、単体で読めます。無料期間は9月12日(土)16:59まで、Kindle Unlimited でも読めます。「AIエージェントに介護をまかせる」のページはこちら